Por Erika Pessôa, CEO da Pessoa Comunicação, Criadora do Método PR Intelligence e Membro do Comitê de Inovação da Abracom.
Durante décadas, a reputação foi definida pelo que se dizia nos bastidores. Depois, passamos a medir o que era dito nos feeds. Agora, na Era da Reputação Algorítmica, um novo stakeholder entrou na sala de reunião: a IA Generativa.
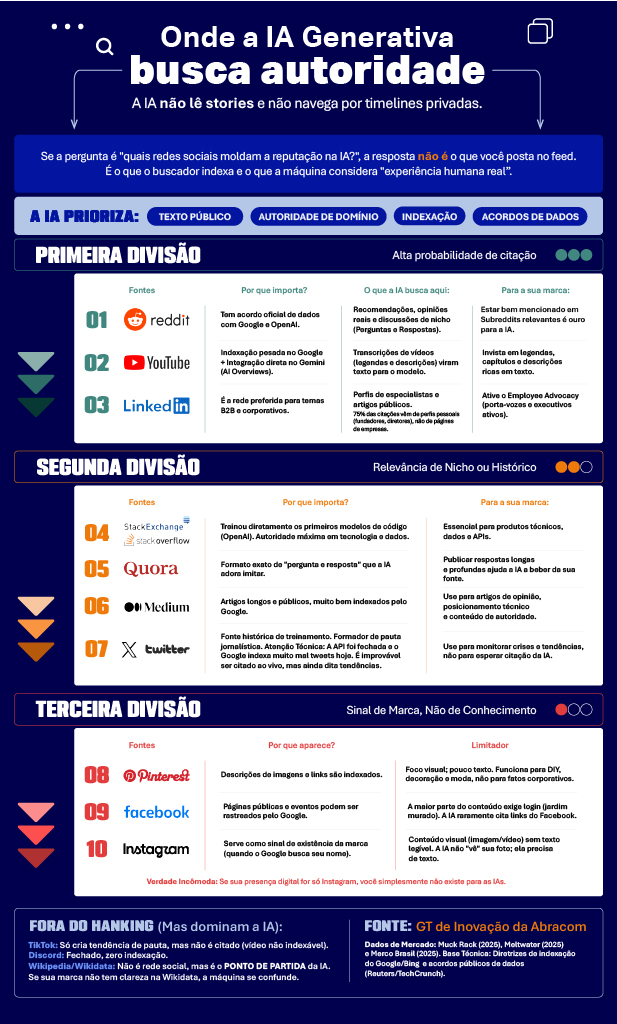
Mergulhados em inúmeros LLMs como ChatGPT, Gemini, Copilot, Perplexity, entre outras, a pergunta que ecoa entre especialistas em Comunicação Corporativa é: “Como IA e redes sociais moldam a reputação?” [Confira o infográfico: Onde a IA Generativa busca autoridade]
Para começar, é preciso desfazer mitos. Para atuar nesse campo, é preciso separar dois conceitos – memória e busca em tempo real – que costumam ser confundidos:
- O Treinamento (Memória): LLMs como o GPT-4 ou o Gemini são treinados em trilhões de parâmetros (textos da internet, livros, Wikipedia). Esse processo acontece em um período específico e acaba. Quando um modelo aprende, ele não fica “navegando” pelas redes sociais para se atualizar. Se uma notícia explode hoje, os pesos do modelo não mudam imediatamente.
- A Busca em Tempo Real (Contexto/RAG): Quando você pergunta algo a um assistente de IA moderno, ele frequentemente faz uma busca na internet (Google/Bing), lê os resultados e usa esse contexto para responder. É aqui que a reputação digital acontece.
Portanto, se a marca do seu cliente é cancelada no TikTok, a IA pode não saber. Mas se esse cancelamento virar uma notícia indexada na Exame.com, um verbete na Wikipédia ou uma discussão massiva no Reddit, aí sim a máquina vai “aprender” e repetir esse escândalo.
Pesquisas recentes revelam de onde a IA tira suas informações. A Meltwater, por sua vez, examinou 9,5 milhões de citações B2B. Plataformas como LinkedIn, Reddit e YouTube concentraram 47,5% das menções. O dado mais impactante? 75% das citações no LinkedIn vieram de perfis pessoais de especialistas, não de páginas de empresas.
A IA não quer saber o que a empresa fala de si mesma, e sim o que os funcionários e líderes falam. O Employee Advocacy e o Personal Branding de executivos se tornaram ativos técnicos de Reputação Algorítmica.
Já os dados do Merco Brasil 2025 (Natura, Grupo Boticário, Itaú Unibanco e Magazine Luiza no topo) nos lembram que a base da reputação continua sendo a conduta, a experiência e o reconhecimento humano. O ranking cruza 364.887 menções digitais e indicadores ESG. A IA bebe dessa mesma fonte. Ela não inventa a reputação do zero; ela consolida a memória pública.
A Muck Rack, uma das principais plataformas globais de PR e monitoramento de mídia, analisou mais de 25 milhões de links citados por ChatGPT, Claude e Gemini. Cerca de 84% vieram de fontes externas e não pagas — categoria que reúne jornalismo, pesquisas acadêmicas, governos, ONGs, enciclopédias e conteúdo de terceiros. As fontes jornalísticas responderam por 27% das citações. Já redes sociais e conteúdo gerado por usuários representaram 2,9% das citações analisadas pelos LLMs (ChatGPT, Claude e Gemini).
Conteúdo pago? Apenas 0,3%. Ou seja, quando a IA formula uma resposta textual, ela age como um jornalista ou acadêmico. Ela busca o que parece mais confiável, citável e validado pela sociedade.
E sim, antes que você pergunte, a era da venda de anúncios chegou às LLMs. A OpenAI anunciou neste mês de agosto de 2026 mudanças na Camada de Interface e Monetização. A partir de agora, quando o ChatGPT ativar o modo de busca (SearchGPT), ele vai mostrar respostas, mas também exibirá boxes de links patrocinados, claramente identificados como “Patrocinado” ou “Ad”, de forma semelhante ao que o Google faz.
Mas isso não muda o que a IA responde. O texto gerado organicamente continuará se baseando em fontes autoritativas. O anúncio será uma camada visual separada. É a separação entre Reputação (Ganhar a citação) e Performance (Pagar pelo clique).
Mas, e quanto a dúvida que trouxe a este artigo: as “IAs aprendem com as redes sociais”? Modelos de linguagem podem utilizar conteúdo público no treinamento. Quando conectados à internet, recuperam páginas durante a consulta. O resultado varia conforme modelo, pergunta, data, acesso e relevância. As redes sociais participam desse ecossistema; não são um cérebro que absorve cada postagem em tempo real.
Para desfazer o hype, a verdade é esta:
- LLMs não aprendem em tempo real com as redes sociais. A viralidade de um post não altera os pesos do modelo instantaneamente. O fluxo real é: Plataforma social → API/Licença → Indexação → Curadoria → Treinamento OU Busca.
- Redes sociais são fontes secundárias e ruidosas. Linguagem informal, desinformação, sarcasmo e spam não são uma base confiável de fatos e, portanto, não ganham relevância nas pesquisas das LLMs. Além disso, boa parte do social não é indexável (Stories, Reels sem transcrição, posts privados, imagens sem texto).
- Baixa autoridade social não é sinônimo de poucos seguidores. Depende de autoria, conhecimento, consistência, atualidade, indexação e reconhecimento externo. Uma empresa pode publicar diariamente e continuar irrelevante porque oferece publicidade onde deveria haver informação, por exemplo.
- Se a marca tem baixa autoridade digital, a IA pode ignorá-la ou citá-la mal. Isso vale para redes sociais, mas também para sites e imprensa. A entidade precisa existir em fontes que o ecossistema reconhece.
O social importa, sim, mas como termômetro de pauta, não como fonte de treinamento da máquina. Se você quer que a IA fale bem do seu cliente, tire o foco do feed e volte o olhar para a construção de autoridade real, presença de especialistas e relações públicas digitais. A reputação sempre foi sobre o que dizem de você quando você sai da sala. Hoje, a IA é a pessoa que fica na sala para sempre, resumindo a conversa para os próximos visitantes. Cabe a nós treiná-la bem.
Curadoria de Conteúdo (Cinco recomendações para agências)
- Diferencie treinamento de busca em tempo real: Como os modelos são desenvolvidos.
- Audite as fontes das respostas: What Is AI Reading? (Muck Rack).
- Torne especialistas reais em fontes públicas: LinkedIn e busca por IA (Meltwater).
- Garanta indexação e valor informacional; dispense “hacks”: Guia do Google.
- Adote uso responsável, revisão humana e transparência: Trust in the Age of Generative AI.